扫码联系客服


 这两年,“虚拟细胞”(virtual cell)火得一塌糊涂。纵横顶刊,连做单细胞分析的工具包都开始写“迈向虚拟细胞的第一步”。
今天小编就较真一下,问一个最基础的问题:给细胞一个模拟刺激,比如一个药物、一次基因敲除、一段缺氧,甚至一次环境暴露,能不能算出这个细胞在所有层面的变化?转录组、甲基化、蛋白怎么变?磷酸化级联、代谢通量往哪个方向偏移?
别想了,现在就是还做不到
https://i.imgs.ovh/2026/11/11/4197e98d4034dfe2e19d3c645563c68b.png
而且更扎心的是,现在大多数所谓的“虚拟细胞”,本质上只是转录组的复读机(小编头不够铁,求放过)。
你给它一个扰动,它给你输出“一段看起来很像转录组响应”的基因表达谱。至于蛋白、磷酸化、代谢、染色质?对不起,模型没见过更没学过。
那怎么办?
今天我们就来聊聊:真正的虚拟细胞应该长什么样,我们现在缺什么,以及它到底能用来干什么。
什么是“真正的”虚拟细胞?
先说背景,2024年,Bunne等人在Cell上发表了一篇标志性观点文章,正式提出了AI虚拟细胞(AI Virtual Cell, AIVC)的概念:
这是一个从多模态数据中学习出来的、能对细胞状态进行高保真模拟的计算模型,可以在计算机里做精确、可扩展的“实验”,在特定场景下补充甚至替代传统湿实验。
这里,请注意两个关键词:多模态和模拟。
打个比方:“虚拟细胞”对于细胞,往通俗了说,就像“天气预报”对于大气。输入今天的初始条件,再输入一个扰动(比如一股冷空气),它输出的是整个系统接下来怎么演化:比如温度、湿度、风向、风速、降水,甚至气压,体感温度等等。
而现在的“虚拟细胞”是什么状态呢?相当于一个只会预报温度、还经常报错的天气预报。(小编这句话没有别的意思)

对此内容感兴趣?免费获取1V1定制方案设计,已为超过500家医院及科研单位提供技术支持服务
第一:缺维度
维度。但转录组只是细胞的一层“投影”,mRNA丰度和蛋白丰度的相关性是出了名的有限(大家都知道mRNA表达高不代表百分百蛋白丰度就高),并且决定信号通路开关的是磷酸化,决定表型的执行者是代谢物,决定细胞记忆的是甲基化和染色质状态。
那我们构建“虚拟细胞”如果只看转录组,是不是就太单一了。而且,分析时总说多组学,构建虚拟细胞时偏偏听不见了,这可不合理噢~
第二:缺动力学
现有模型学到的多是静态快照:这个状态下基因长这样,那个状态下长那样。但细胞是活的,刺激之后有一个时间轴:磷酸化在分钟级响应,转录在小时级跟上,蛋白组在半天后重塑,表型变化要以天计。一个没有时间维度的虚拟细胞,回答不了“什么时候会发生什么”。
当然你要说,现在已经有时间维度训练过的虚拟细胞模型了,例如XXXXX,我就不说啦,但你真正想过吗,不同维度的变化时速都不一样,它输出的结果是瞬时的还是连续的?你要说,现在不是转录组这一个层面的嘛,我只看这一个层面的,那没问题,但它并不是真正的虚拟细胞,只能说是一个聚焦于某一维度的虚拟模型。
第三:比较尴尬的是准确率的问题
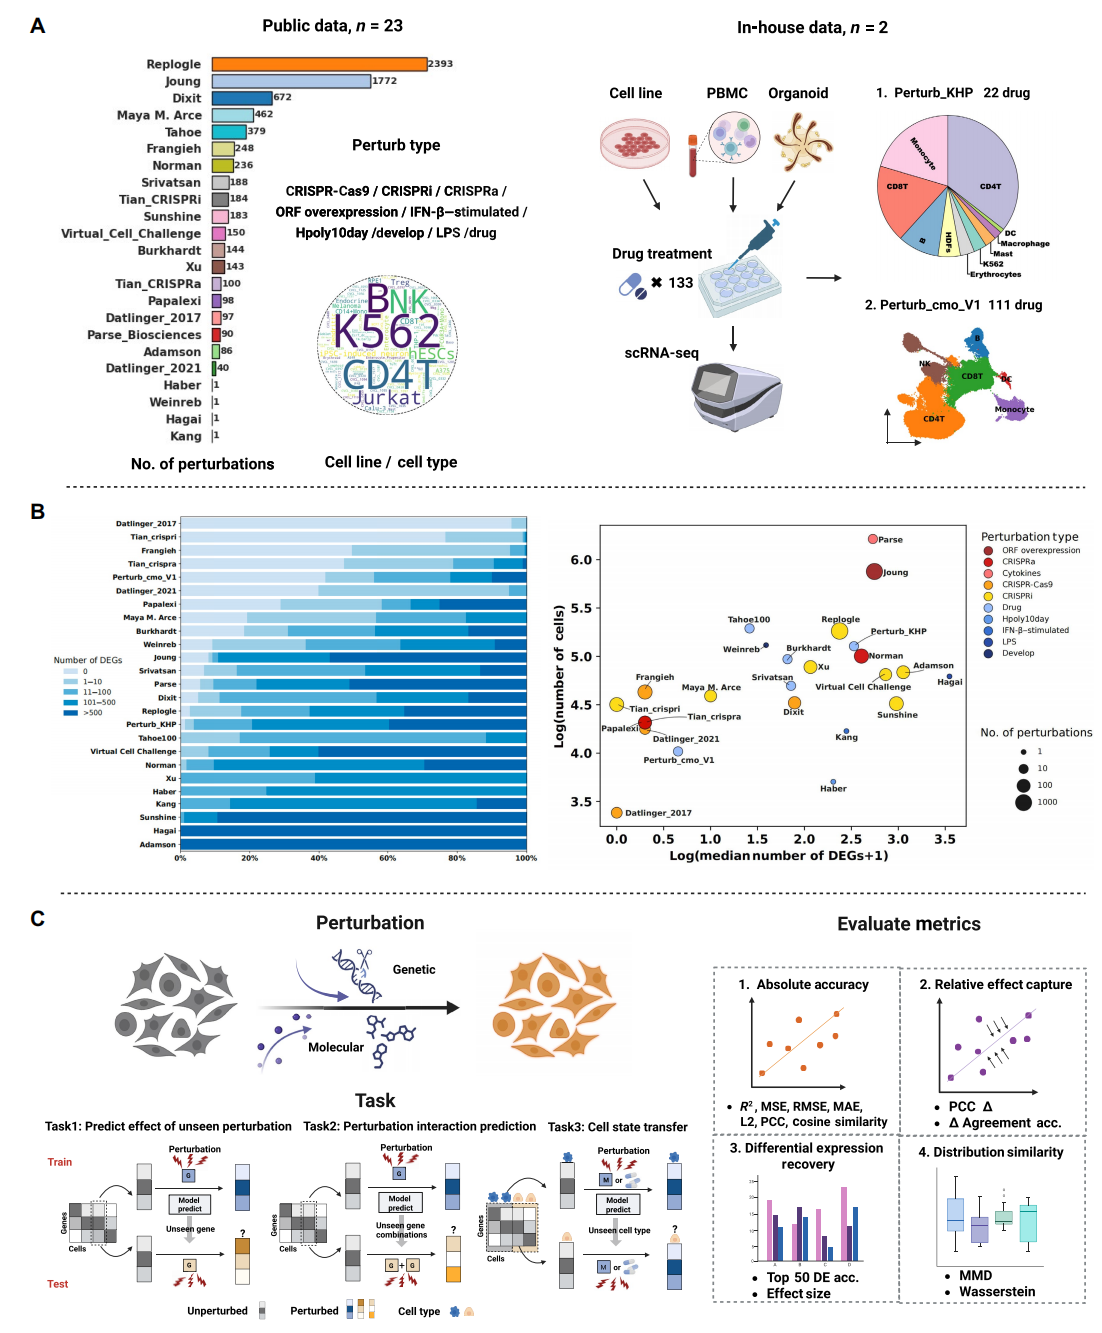
今年9月份,发表在Science Advances的一项系统评估,测试了13个单细胞扰动响应预测模型。结果“不尽如人意”。
这些模型性能高度依赖扰动效应的大小和评估视角,换一个角度测试,排名就又打乱了。
年另一项工作显示了同样的结论。
“信号-界限-基线”(SBB)原则,发现不少复杂的深度学习方法,居然打不过简单的线性基线。
翻译一下:现在的很多“虚拟细胞”,预测出来的“响应”,可能只是把训练数据里的平均表达水平换了个说法。这不是虚拟细胞,这是虚拟复读机。(再次狗头保命)
换句话说,虚拟细胞正确的打开方式是什么?
其实去年就有人在Cell Research上提出了一个很形象的框架。
像养细胞一样,“养”一个虚拟细胞,它需要三种“培养基”成分,也就是三大数据支柱。
支柱一:先验知识(a priori knowledge)。文献、已有组学数据、分子通路、从微生物到酵母的全细胞模型。这些数据已经存在(前提是不掺水),不需要额外花钱生成,是性价比最高的起点。但它们碎片化、跨细胞类型,光靠它们建不出一个特定细胞的虚拟模型。
支柱二:静态架构(static architecture)。对一个特定细胞的“全景拍照”:冷冻电镜、冷冻电子断层扫描、超分辨荧光成像、空间组学,把细胞的分子结构和空间组织完整记录下来。这是细胞的“解剖图”。
支柱三:动态状态(dynamic states)。这是最关键也最稀缺的一块,细胞在各种自然过程(例如衰老、分化、癌变等)和人工扰动(比如药物、基因敲除、物理刺激等)下的全层面响应数据。
作者特别强调扰动蛋白组的价值:蛋白是细胞的结构成分和催化核心,而质谱蛋白组还能同时捕捉翻译后修饰(比如磷酸化)。
理想中的实验形态是这样的:同一群细胞,给刺激,然后在分钟、小时、天的多个时间点上,把转录组、甲基化/染色质可及性、蛋白组、磷酸化蛋白组、代谢组、细胞形态、空间邻域关系全部测一遍。刺激前测基线,刺激后测响应。这样的配对多模态扰动数据,才是虚拟细胞的“生长因子”。
数据有了,怎么让它越来越聪明?这篇文章还提出了闭环主动学习:
AI模型找出自己最不确定的知识缺口(比如应激通路里一段没被测过的磷酸化事件),自动指挥机器人平台去做时间分辨的磷酸化蛋白组实验,数据回流再训练模型,循环往复。作者估计,这种闭环能把过去需要数年的假设验证压缩到几周。
沿着这条路走下去的终点,就是我们开头描述的那个理想形态。
真正的虚拟细胞应该是:
输入一个刺激(例如小分子药物、CRISPR敲除、机械力、缺氧、细胞因子等等),输出这个细胞或这群细胞在所有层面的变化曲线:基因表达怎么变化、染色质哪里开了/关了、蛋白丰度是怎么重排的、磷酸化级联又是怎么逐级传递、代谢通量往哪个方向偏、细胞形态和空间关系如何重塑、最终走向增殖、分化还是凋亡。
从“测一层”到“算全部”,这是真正的虚拟细胞和“普通虚拟预测模型”的分水岭。而支撑这个愿景的,大概可以用去年发表在Nature的这篇文章提出的多模态基础模型路线来类比。
“在跨模态、跨尺度的海量组学数据上预训练,构建细胞、基因、组织的‘整体地图’,让模型天然理解不同分子层之间的耦合关系”。
你要问,为什么提出真正虚拟细胞愿景的都是去年的,今天却没有真正的虚拟细胞呢?
小编只能瞎说理想丰满,现实骨感,再给点时间。
药物筛选和组合用药。这应该是目前最迫切的应用场景。直接预测药物在特定癌细胞里的疗效和协同组合,绕开“先筛几千个化合物再说”的高成本路径。对组合用药来说尤其值钱,单是两种药物的组合都是指数级的,想要用湿实验一个一个来做,那简直是非人力可为,对,非人力,AIVC可以。
2. 靶点优先级排序。在决定敲任何一个基因之前,先在虚拟细胞里“敲”一遍,看哪些靶点的虚拟扰动能把疾病状态拉回正常方向,再选择最值得验证的候选靶点做实验。从“大海捞针”变成“按图索骥”,AIVC可以。
3. 患者数字孪生。用患者肿瘤样本的基线多组学数据构建个体化的虚拟细胞,在AIVC里试药:这个患者对哪种方案响应、会不会耐药。
正巧,2025年发表在npj Digital Medicine的一篇综述“AI-driven virtual cell models in preclinical research: technical pathways, validation mechanisms, and clinical translation potential”系统梳理了这条转化路径。
从个性化药物筛选、疾病建模到监管审批,同时也点出了拦路虎:模型可解释性、验证标准和监管接受度。
4. 毒性与安全性预测。肝毒性、心脏毒性往往在临床前后期才暴露。如果虚拟细胞能对候选药物做全层面的“虚拟给药”,很多失败可以提前在计算机里拦截。
5. 实验设计本身。这可能是最被低估的应用:虚拟细胞最大的价值不是替代实验,而是让每一次实验都更聪明,先在计算机里缩小范围、排好优先级,再把“时间、精力、资金”花在刀刃上。
.......
回到最开始的问题:现在的虚拟细胞是真正的虚拟细胞吗?
虽然不是,但方向是对的,而且路径已经清晰:用多模态数据养模型,用AI主动学习补数据,用严格基准促进模型进化。
在那之前,我们可以做的是:用虚拟细胞提出假设,用湿实验验证因果,用多组学记录全过程。虚拟细胞不是要取代实验,而是要让我们少做无用的实验。
第一批真正意义上的虚拟细胞,也许会先诞生在酵母里,然后是癌细胞系,最后才是患者组织。硅基生命的第一个细胞,也许正在数字培养皿里发芽。